我让 AI 蒸馏了 500 小时交易课程,实测胜率只有十几%——然后我把失败原样公开了
我手里有一套 366 集、506 小时的交易课程,交给 AI 去「蒸馏成系统」。它很快交出了信号、回测和报告,看起来像模像样——实测胜率却只有百分之十几。复盘发现,62 万字的方法卡一条都没被代码引用。于是我推倒重建,把第一代策略的 168 笔实测、39.3% 胜率和 FAIL 判定原样贴在公开看板上。这篇文章讲的就是:一个人,怎么靠一条 AI 流水线,把翻车变成可验证的系统。
答案摊在下面——四套自己开发的系统(两套已上线、两套开发中),和 18 件让开发跑起来的提效工具。所有能公开的部分都给了入口,欢迎逐条核实;每一件工具,都写清了它解决什么开发问题、在整个开发流程里扮演什么角色。
阅读方式:第一部分是翻车与重建的真故事(含失败数据公示);第二部分是成品清单(四套系统,可点开验证);第三部分是开发方法(五个环节,人只守两个决策点);第四部分是提效工具盘点(18 件,全部是我自己开发、在开发线上真正在用的)。
一、先说翻车的那段:从「白蒸馏」到重建(含一次公开的失败)
成品稍后再看——先说翻车的那段,因为它才是这篇文章最想给你看的东西。
事情的起点:上一个 AI 做出来的系统,胜率只有百分之十几。
我手里有一套完整的交易课程:366 集、506 小时、151GB 视频。我把它交给 AI 去"蒸馏成一套能用的交易系统"。我先前的期待很简单:课程是完整的,AI 照着做就行。结果它确实"做出来了"——有信号、有回测、有报告,看起来像模像样。但实测胜率只有百分之十几,几乎等于白蒸馏了这 500 小时课程。
复盘出来的根因,比"AI 不行"严重得多:
- 知识建了,但一个字没用上——62 万字的方法卡建完之后,信号逻辑代码里没有引用任何一条课程规则。回测测的其实是一个"简化版的普通策略",跟那 500 小时课程没关系。
- 核心战法被当成"基础"漏掉了——12 金 K、2B、双龙这些入场战法,转录里都有,但逐集笔记 0 篇——因为当时被分类成"基础篇",优先级被排到了后面。
- 口径张冠李戴——课程明说某些指标"不作为主要依据",代码却把它们做主入场;28 条规则里有 8 条根本没法从 K 线数据直接量化(颈线、谐波、Spring 这些要靠人眼看的结构)。
于是 2026 年 8 月底,我决定推倒重建。重建的思路就一条:把"课程知识"真正变成系统里可被引用、可被验证的一等公民——
| 阶段 | 做什么 | 规模(真实数字) |
|---|---|---|
| ① 全量转录 | 366 集课程逐集转写、逐集笔记 | 349/350 集完成(95%);151GB / 897 个文件 |
| ② 无损蒸馏 | 课程 → 方法卡(原文级保留,含出处) | 12 张方法卡,合计 772 万字节 |
| ③ 结构化 | 方法卡 → 12 张"决策卡"(S/A/B 分层 + 机器可执行的规则 ID) | 2467 帧视觉锚点(每个形态都有定格证据) |
| ④ 数据底座 | 聚合成交明细 + 行情数据落本地 | aggTrades 38GB / 4078 个日度包(2020-12-31 至今)+ 行情树 175GB |
| ⑤ 回测验证 | 33 个月开发窗口、217 条目数据清单、逐笔留痕 | 内核测试 272/272 全绿(双模式) |
然后是最重要的部分:结果怎么公示的。
第一代策略(Gen1)跑完了 168 笔实测,结果并不好看——我就把不好看的结果原样贴在公开看板上:
| 指标 | Gen1 实测值 | 判定 |
|---|---|---|
| 样本 | 168 笔(2021-01 至 2023-09 开发窗口) | — |
| 胜率 | 39.3%(66 胜 / 102 负) | 低于门槛 |
| 平均 R | −0.188 | 负期望 |
| 盈利因子 | 0.767 | < 1,亏损 |
| 最大回撤 | 20.3%(2022-12-19 触发 20% 熔断) | 触发硬停 |
| 结论 | Gen1 判定 FAIL,全体下线,第二代另起预注册——看板上原样公示,不修图、不藏数据 | |
这就是这个系统最反直觉的地方:它公开自己是"失败"的。看板顶部写着 EXECUTION_AUTHORITY: NONE——不接资金、不执行交易、只出信号;策略卡的实测数据里,"未通过"照样挂在表里。因为搞研究最贵的不是失败,是假成功:如果一个系统连自己的失败都不敢公示,它给出的任何一个"通过"都不值得信。
二、再看成品:四套系统
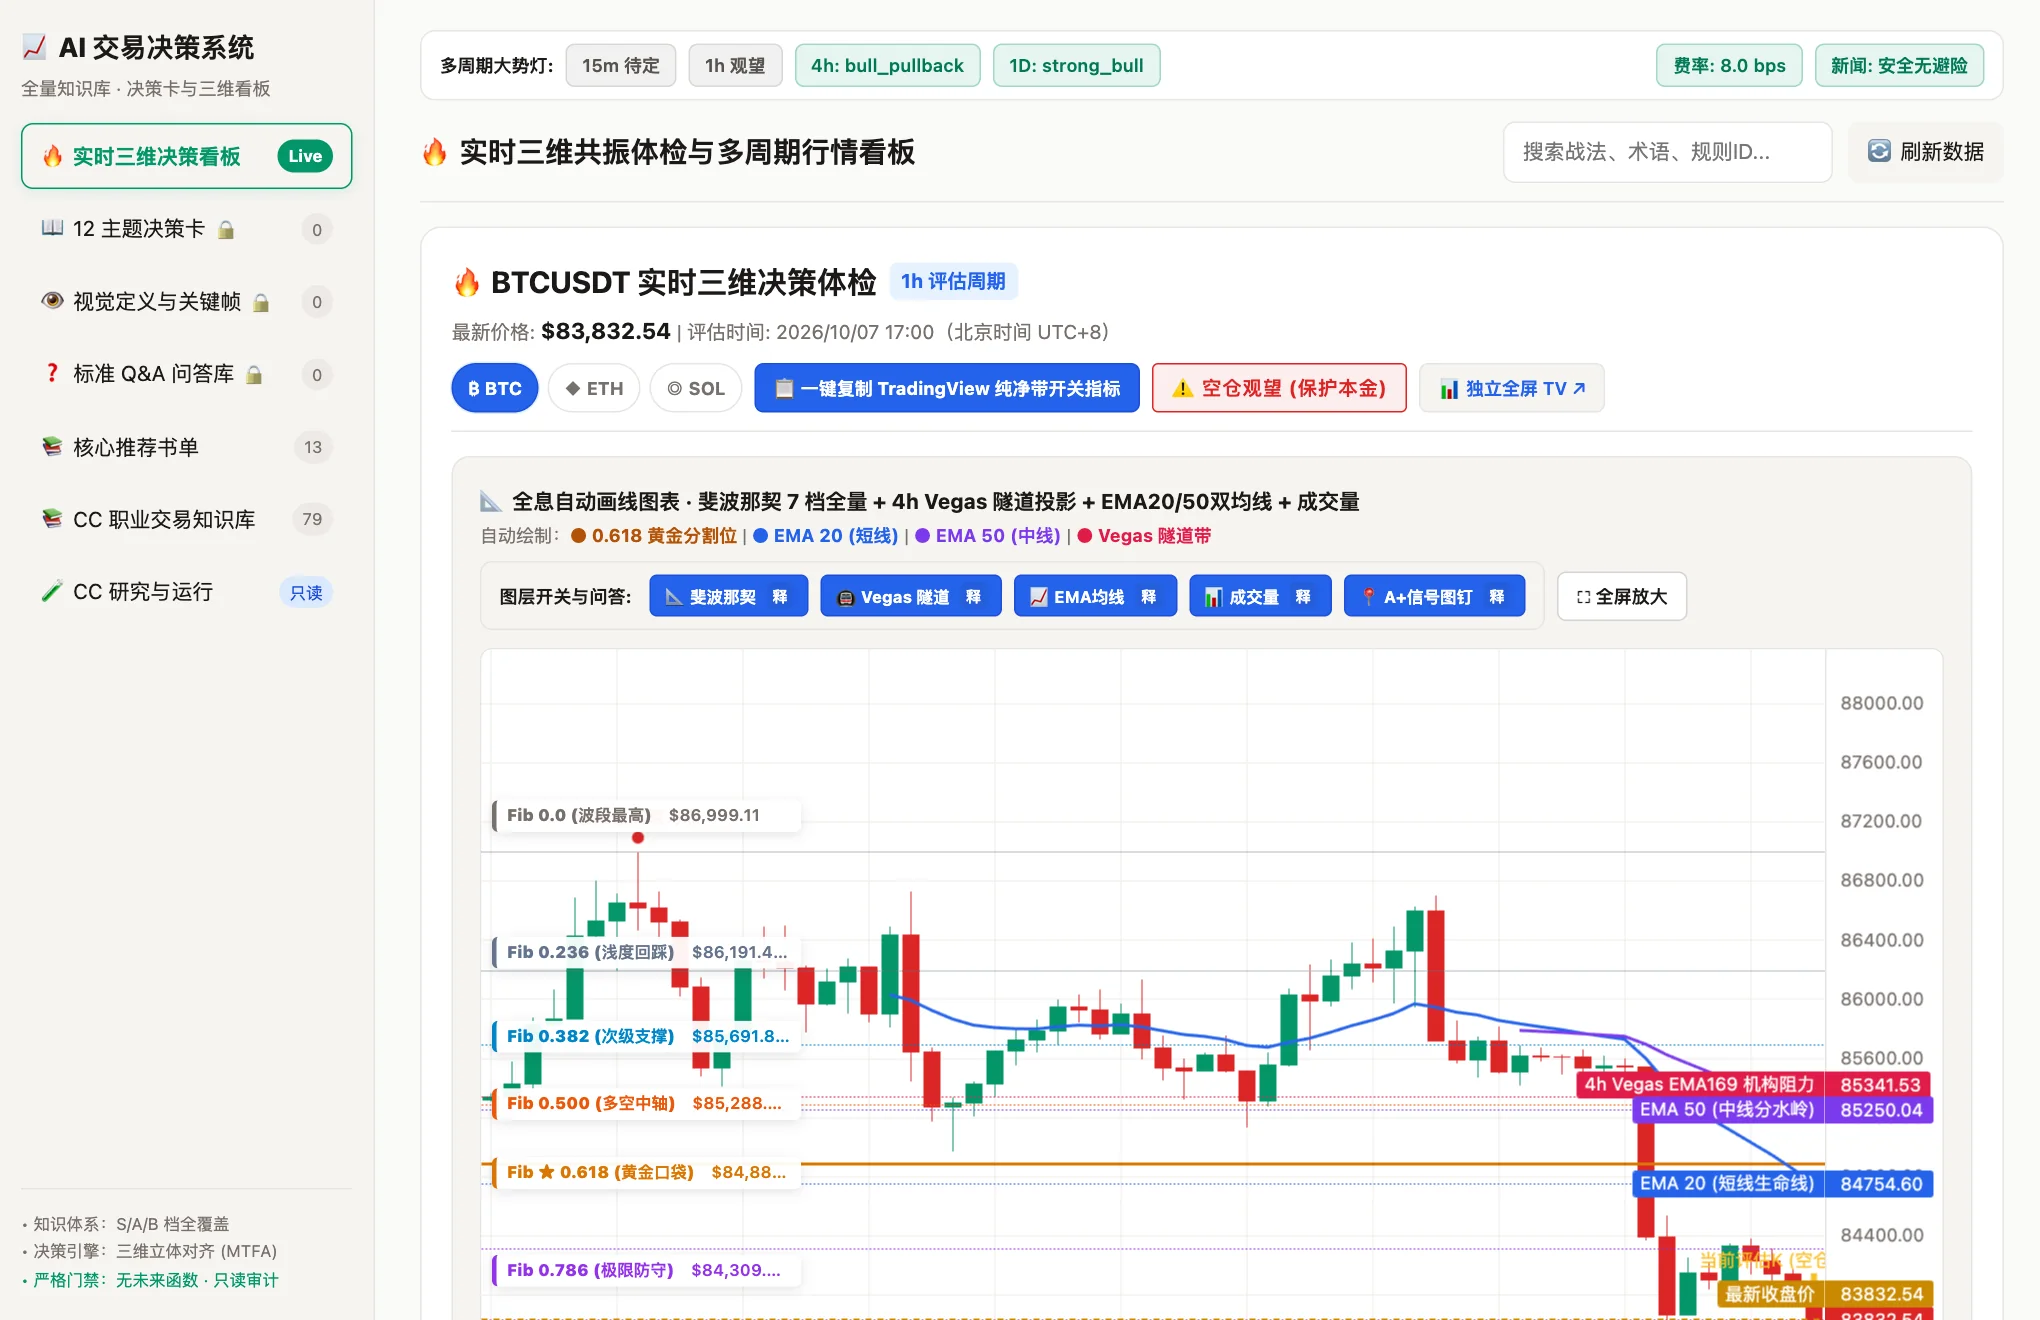
① AI 交易决策系统(内部系统 · 下图为界面实拍)


知识库负责「怎么判断」,驾驶舱负责「判断是怎么被执行的」——每一条结论背后是哪些证据、什么状态,全部留痕可查。它的开发管线用到了下面盘点里的:外脑协作系统、Codex 团队调度、长任务协议、审核调度、Kiro 终审等 10 余件工具。
② 本站与会员体系(就是你正在看的这个网站)
本站不需要截图——它本身就是证据。这个网站从设计、改版到上线,以及背后的账号注册、登录、会员权益、USDT 支付通道、邮件通知,全部由同一套流程开发:ChatGPT 定方向、Agent 写实现、独立模型审核、逐项验收上线。
可以顺手验证:打开 主页 看看导航与板块结构,注册一个账号走一遍 会员中心 的流程——你看到的每一个页面、每一次「已生效」的背后,都是这条开发线在跑。
③ 内容自动化系统(开发中)
把内容信号自动采集进来、变成选题、进入处理队列——这套系统正在开发中,部分环节已经在服务器上常驻运转。它证明的是:这套开发方法不只适用于交易系统,任何「有明确输入输出」的系统都能用同一条流水线做出来。
④ 公众号运营自动化(开发中)
公众号图文的一键排版、自动配图、草稿上传与发布承接——同样由 ChatGPT 定方向、Agent 写实现、独立模型审核的流程在开发中。开发过程与①②③共用同一套工具链(见第四部分)。
三、开发流水线:五个环节,人只守两个决策点
四套系统形态不同,但开发方法完全一样——把「做系统」当成一条流水线:原料是需求,成品是上线系统,中间五个工位,每个工位都有明确的产出物和验收标准。而我的角色是质量总监:只在方向确认和上线许可两个点上拍板,其余全部交给流水线。
「开发」和「生产」的区别在于:开发可以靠灵感,生产必须可重复、可度量、可追责。这条线上的每一步,都是为了后三个词服务的。下面五个环节,是这条线在开发四套系统时反复执行的动作。
先亮「公司架构」:五个 AI 员工,一个人类老板
这条流水线能跑起来,靠的是一支特殊团队——产品、UI 设计、研发、审核、测试五个岗位全部由 AI 坐班,公司里的人类只有一个人(负责拍板与担责)。这就是我说的「一人开发公司」,先看分工表:
| 岗位 | 员工 | 负责什么 | 出场位置 |
|---|---|---|---|
| 产品经理 | GPT(ChatGPT 最大档) | 定方向、写需求、调研、方案裁决、定验收标准 | 流水线第 1–2 环 |
| UI 设计师 | Google Stitch(AI 设计工具) | 生成整套界面设计系统:配色 / 字体 / 组件 / 暗色主题 | 需要界面时 |
| 研发工程师 | Codex / DeepSeek / Claude(多模型分档上岗) | 并行写代码、跑测试、批量实现 | 流水线第 3 环 · 执行 |
| 审核官 | Opus / Fable 等顶级模型(轮换、不与作者同岗) | 独立挑刺、交叉复算、打回重做 | 流水线第 4 环 · 审核 |
| 测试员 | AI 验收测试体系(自研 skill:Playwright + CI 自动验收) | 每次改动自动跑全站冒烟 + 截图比对,红灯不放行——见下方补岗说明 | 每环兜底 · 上线前最后一道门 |
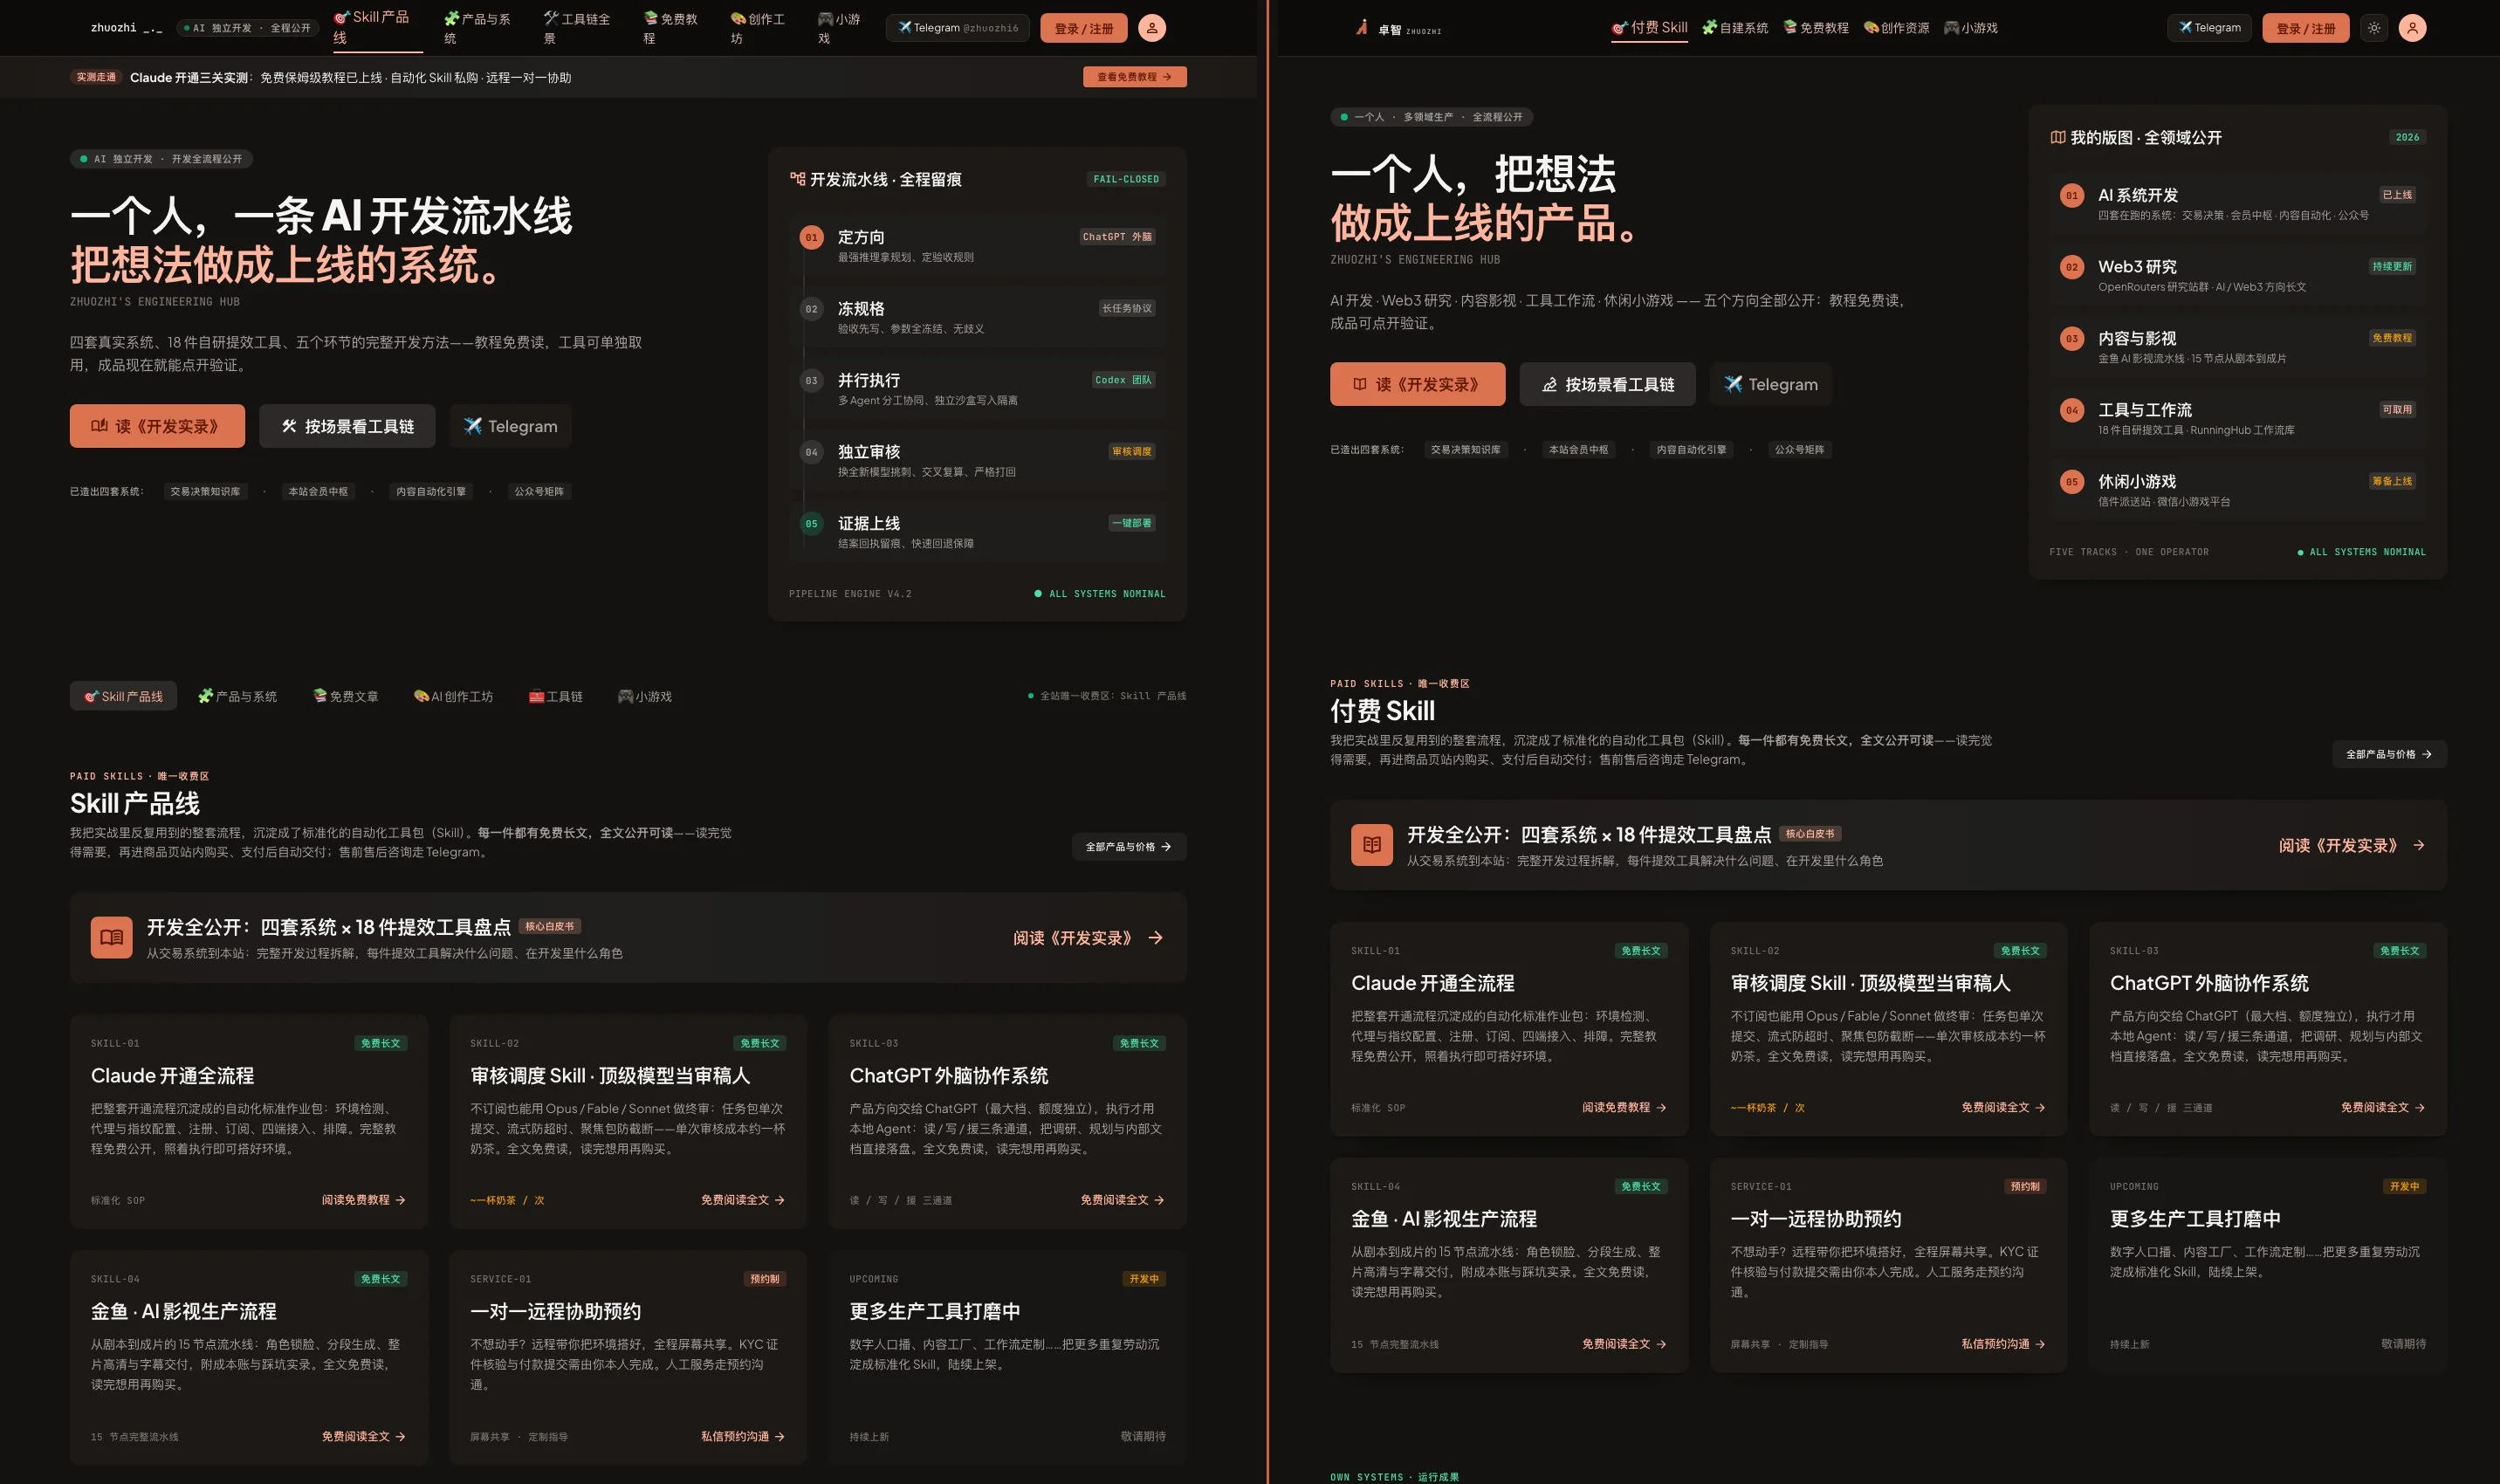
你正在看的这个网站就是活证据:首页、文章页、暗色主题的整套视觉,都是 Stitch 先生成设计系统、再由研发岗(Codex 团队)实现上线的。四套系统的界面,走的都是这条「设计 → 实现」的直线。
环节一 · 方向:把「要什么」交给最强推理
第一个坑,90% 的人第一步就踩了:把方向问题问给了执行模型。当你让一个写代码的 Agent「自己想想该做成什么样」,你得到的是它脑内的平均值——而不是对你最有价值的选择。
这条开发线上的分工是固定的:方向归最强推理模型(我用 ChatGPT 的最大档),执行归本地 Agent。两者额度独立、能力画像不同,混用只会两头都亏(详见另一篇《把 ChatGPT 网页端用成你的产品经理》)。
这一步的产出物不是「聊天记录」,是三样能直接进入流水线的东西:
- 规格草案:要做什么、不做什么、边界在哪;
- 验收标准:用什么证明每一步做成了;
- 风险清单:哪些地方可能翻车、翻车了怎么回退。
一个实操细节:给方向模型的材料要一次性给全——现状、目标、限制、已试过什么。挤牙膏式的一问一答,会把最强的模型降级成最贵的搜索引擎。
环节二 · 规格:先把失败钉死
先写验收,再写实现。验收标准不是最后一道关,是第一份文件。
这是整条开发线最反直觉、也最值钱的一条纪律。大多数项目死在「做完了才发现不知道算不算做完」;而这条线在动工之前,就把「什么算成功、什么算失败、失败到什么程度就停」全部写死。
尤其是涉及权限与资金的部分,规格里先写「不许做什么」:
- 权限门默认关闭,够不着就是够不着(fail-closed:不确定就锁死,而不是不确定就放行);
- 涉及金额的计算先定精度与校验规则,再谈功能;
- 一旦开跑,参数冻结——参数不许回头改;想改 = 重开一局,严禁「改到通过为止」(那是对结果的过拟合,不是成功)。
这些文档不存在某个人的脑子里,全部落盘到共享空间:每个项目的规格、评审记录、交接单随手可查——后面的执行与审核角色,都对着同一份白纸黑字干活。

环节三 · 执行:并发,但写入隔离
到了干活环节,效率来源只有一个词:并发。把一个系统拆成若干「彼此独立、写入互不重叠」的任务块,交给多个 Agent 同时推进——这是四套系统能在有限时间里推进的核心原因。
并发有三个纪律,违反了比串行还慢:
- 写入隔离:每个执行者只碰自己的地盘,谁都不许越界改别人的文件;
- 上限控制:并行度服从机器资源和风险等级,不凑数、不榨干;
- 主控只回收产物:不允许多个 Agent 互相直接改——所有集成都回到主控做,冲突在这一层消化。
另一个被低估的点:模型档位要分级。确定性的脏活(批量处理、格式转换、跑测试)给最便宜的执行档,难活(核心逻辑、复杂重构)给强力档——同一件事,成本能差十倍以上,效果却没有差别。
环节四 · 审核:执行者永远不自审
自己审自己 = 没有审。审核必须是独立的角色、独立的通道、独立的证据。
这条线上每一个关键产出,都要过一个审核门:换一个模型、换一份上下文,对着规格逐条挑错;能复算的复算,能重放的用例重放;不同意就打回去回炉。执行者说「做完了」不算数,审核者说「查过了」才有分量。
用什么来审?顶级模型——但不按订阅烧钱用。这里用的就是「审核调度 Skill」那套纪律:单次任务包提交、流式防超时、聚焦包防截断,单次审核成本≈一杯奶茶。审稿人不需要陪跑整个项目,它只需要在最关键的几个点上,用最强的脑子看一次。
| 产出物 | 谁执行 | 谁审核 |
|---|---|---|
| 规格与方向 | 方向模型(ChatGPT) | 换角度交叉评审(第二模型 / 人类总监) |
| 代码与脚本 | 执行 Agent(按难度分级) | 独立 Agent + 自动化测试(不同上下文) |
| 数据与数值 | 执行 Agent | 独立复算(另一实现路径算同一结果) |
| 上线动作 | 主控执行 | 验收脚本 + 上线许可(人类总监) |
环节五 · 验收:一切以证据结案
没有证据的「完成」,一律按「没完成」处理。
这条线上「证据」的定义很具体:验收脚本的绿色输出、线上页面的实拍、接口回执、审计日志。口头汇报不算,聊天记录不算,「我觉得没问题」不算。
还有一个让系统不翻车的开关:fail-closed。不知道就停,不确定就锁死,出异常就回退。停着的代价永远小于猜错的代价——尤其当系统涉及权限、金额这类「错了就收不回来」的领域。
上线也不是终点:每一次变更都要留痕——谁、何时、改了什么、为什么。出了事能回溯到具体动作,而不是一句「不知道怎么回事」。
四、18 件提效工具盘点
下面是整个开发流程里真正在用的提效工具(我自己开发/打磨的 Skill 与自动化套件)。只收录三类:开发造系统时用的、起到关键作用的、属于我这套工作流自己的——第三方技能库和边角工具一律不占篇幅。每件都写了:解决什么开发问题、在开发流程中的角色。状态说明:已开售 有专门文章可读、可直接购买;可咨询 支持单独交付与配置指导;内部运行 是我自用的系统,暂不对外。
A 组 · 协作与调度(把活派出去)
| 工具 | 解决什么开发问题 | 开发流程中的角色 | 状态 |
|---|---|---|---|
| ChatGPT 外脑协作系统 | 方向问题交给 ChatGPT 最强推理,执行交给本地 Agent;读 / 写 / 援三条通道把项目直接接进对话 | 四套系统的「想」环节:拿规划、做评审、文档落盘 | 已开售 文章 |
| ChatGPT × Codex 协作桥 | ChatGPT 当大脑与裁判、Codex 当执行器:统一契约、脱敏、安全门与真实证据,一条链完成仓库任务 | 「想 → 做」之间的传送带,全程不离开官方通道 | 可咨询 |
| Codex 团队调度 | 组建和调度多模型团队:分工执行、独立研判委员会、双审门禁、运行中换模型 | 交易系统的多 Agent 并行执行与本站在线更新 | 可咨询 |
| 长任务协议 | 文件事实源 + 检查点 + 证据化交付,几百步的任务跨会话不失忆、可恢复 | 多系统并行推进的调度骨架 | 可咨询 |
| 长任务编排器 | 昂贵主控只做任务切分与阶段验收,子 Agent 分步执行——主控 token 省着烧 | 大批量执行任务的成本控制 | 可咨询 |
| 算力分流 | 把可复现的重计算分流到服务器跑,本地不卡、结果自动取回 | 批量计算与历史数据研究 | 内部运行 |
| 长期记忆库 | 跨会话的长期记忆与资源索引:偏好、决策、教训下次自动召回 | 所有系统的上下文底座 | 内部运行 |
B 组 · 审核与裁决(把错拦住)
| 工具 | 解决什么开发问题 | 开发流程中的角色 | 状态 |
|---|---|---|---|
| 审核调度 Skill | 顶级模型(Opus / Fable / Sonnet)按纪律做独立审核,单次成本≈一杯奶茶 | 每一版关键代码与方案过审:找错、复算、打回 | 已开售 文章 |
| Fable 架构审查 | 顶级模型做架构复核与执行规划,专治「方向级的错」 | 大方案动工前的裁决 | 可咨询 |
| Kiro 终审 | 用另一个通道的 Opus 做独立终审,产出可复核报告 | 上线前的最后一道门 | 可咨询 |
| 多模型对抗审计 | 多个模型独立组队评审 + 红队审计 + 分歧保留,不让任何单一模型说了算 | 关键决策上线前的「唱反调」机制 | 可咨询 |
C 组 · 执行与交付(把系统上线)
| 工具 | 解决什么开发问题 | 开发流程中的角色 | 状态 |
|---|---|---|---|
| 浏览器自动化 | 网页操作、登录、发帖、截图取证、页面数据提取 | 取证、验收与在线操作的执行器 | 内部运行 |
| 个人站一键部署 | 站点源码管理 + 构建 + 部署 + 线上验收一条命令 | 本站每次改版的上线通道 | 内部运行 |
| VPS 生产部署 | 服务器环境部署与安全加固:容器管理、故障恢复、对象存储备份 | 所有上线系统的服务器底座 | 内部运行 |
| 服务器监控告警 | 资源水位与服务健康监控,异常实时推送到协作工具 | 所有上线系统的看护 | 内部运行 |
| 私有工作空间部署 | 跨 macOS / Linux 的私有服务规划、打包、部署与排障 | 开发环境与内部基础设施 | 内部运行 |
D 组 · 领域与前置(开发基础件)
| 工具 | 解决什么开发问题 | 开发流程中的角色 | 状态 |
|---|---|---|---|
| 交易分析卡 | 仓位、止损止盈、交易纪律、策略规则的下单前检查与风险分析 | 交易系统的方法底座 | 内部运行 |
| Claude 开通全流程 Skill | 开发环境的获取与运维:环境检测、指纹与网络配置、注册、订阅、四端接入、防封申诉 | 开发工作站的前置件(已写成教程) | 已开售 教程 |
这份清单不是终点——每件工具都值得单独写一篇「它是怎么干活的」。已经在写的、和接下来的文章顺序,都会从这张表里长出来。
三条最值钱的经验
- 审核权与执行权分离。谁负责做,谁就不参与审;审计只看证据,不看态度。
- 一切以证据结案。截图、回执、日志、复算——缺一项不算完成。「口头完成」是工程上最大的债务。
- fail-closed。不确定就停,停的代价永远小于猜错的代价。参数冻结、不许「改到通过为止」。
常见问题
Q1:完全不用写代码吗?
这条线的日常里,绝大部分环节不需要手写代码——但你需要「看得懂结论」:验收是否通过、数字是否合理、风险是否可控。质量总监不用会拧螺丝,但必须会看质检报告。
Q2:要花多少钱?
主力成本是按量付费的模型调用(用对档位差异巨大,参考《审核调度 Skill》里的实测:单次顶级模型审核≈一杯奶茶),加上一台低配服务器。绝大多数环节可以先用低价档跑通,再升级。
Q3:什么人用这套流水线价值最大?
手里有「明确要做成的东西」但不想陷进工程细节的人:独立开发者、内容团队、做工具/后台/数据管道的个人与小组。反过来,连「什么算成功」都说不清的项目,先别上流水线——先去环节一。
Q4:表里的「可咨询」是什么意思?
说明这件工具已经在真实生产里跑稳了,可以单独交付(含配置指导与落地答疑)。私信说明你的使用场景,我会告诉你适不适合、怎么用。
Q5:这个交易系统能给我信号 / 能跟单吗?
不能。公开的部分是只读的研究与决策辅助系统:可以看到知识库、决策看板与运行留痕,但它不接资金、不执行交易、不提供任何投资建议。本文也不构成任何交易建议。
① 先免费读:本页与之配套的教程全部免费,读完再决定;② 直接取工具包:外脑协作系统 / 审核调度 / AI 影视流程,站内购买、支付确认后自动交付;③ 想让我帮你搭一套:一对一远程协助(预约制),其余「可咨询」工具私信说明场景。
关于本文与说明
文中系统的公开入口(知识库与驾驶舱)均为只读展示,不构成任何交易建议,也不承诺任何收益;截图数据来自公开页面,随时间推移会变化。文中提及的协作流程与成本数字为个人实测参考,不构成效果保证。ChatGPT、OpenAI、Claude、Anthropic 等均为其各自公司的商标,本文所述工具为个人开发的第三方工作流套件,与上述公司无隶属关系;所有平台功能与政策以官方为准。
更多教程与工具:主页 aizhuozhi.com;联系 TG @aizhuozhi。